
เวลาที่เราพัฒนา Web Application ขึ้นมาใหม่ๆ ไม่ว่าจะเป็นระบบเช็คอิน ระบบจัดการพัสดุ หรือหน้าแดชบอร์ดสรุปผล ทุกอย่างมักจะทำงานได้รวดเร็วทันใจคลิกปุ๊บมาปั๊บ แต่เมื่อเวลาผ่านไป ข้อมูลในระบบ (Database) เริ่มสะสมจากหลักร้อยเป็นหลักหมื่นหรือหลักแสนรายการ สิ่งที่ตามมาคือ “ความอืด” เว็บเริ่มหมุนติ้วๆ กว่าจะโหลดข้อมูลเสร็จ
หนึ่งในวิธีแก้ปัญหาที่ทรงประสิทธิภาพที่สุดโดยไม่ต้องอัปเกรดเซิร์ฟเวอร์ให้เปลืองงบประมาณ คือการทำความรู้จักและใช้งานสิ่งที่เรียกว่า Database Index ค่ะ
Database Index คืออะไร?
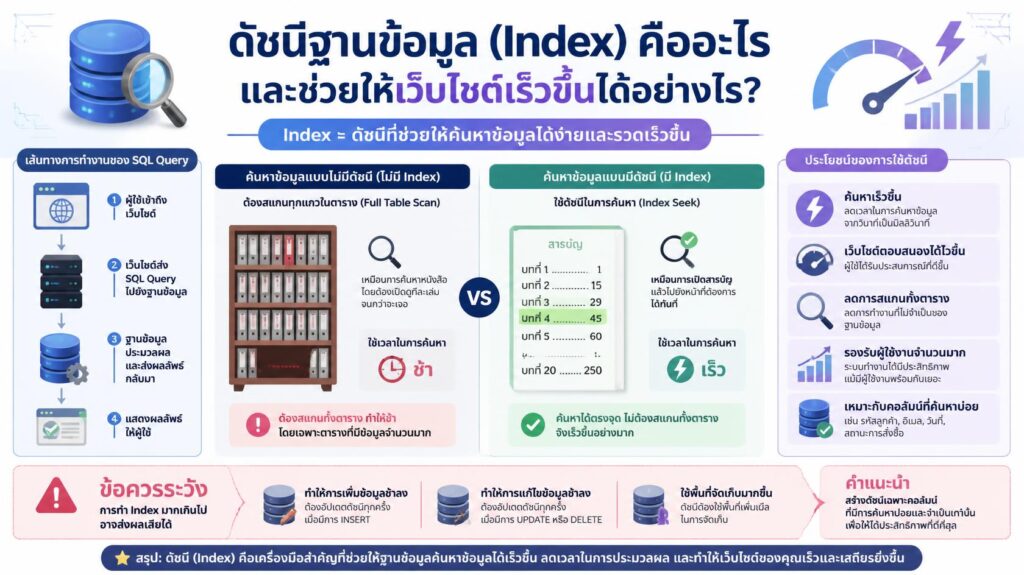
อธิบายให้เห็นภาพง่ายที่สุด Database Index ทำหน้าที่เหมือน “หน้าสารบัญที่อยู่ท้ายเล่มหนังสือ” ค่ะ
ลองจินตนาการว่าเรามีหนังสือคู่มือหนา 1,000 หน้า และต้องการหาข้อมูลเกี่ยวกับ “การสร้าง Web App”
- แบบไม่มีสารบัญ: เราต้องเปิดหาทีละหน้าตั้งแต่หน้า 1 ไปจนถึงหน้า 1,000 เพื่อดูว่ามีคำนี้อยู่หน้าไหนบ้าง (วิธีนี้เสียเวลามาก)
- แบบมีสารบัญ: เราแค่เปิดไปที่หน้าสารบัญตัวอักษร ‘ก’ หาคำว่า “การสร้าง Web App” สารบัญจะบอกทันทีว่าเนื้อหานี้อยู่ที่หน้า 850 เราก็แค่เปิดทะลุไปที่หน้า 850 ได้เลยทันที
ในโลกของฐานข้อมูล (เช่น MySQL หรือ SQLite) ก็เช่นเดียวกันค่ะ เมื่อเราสร้าง Index ให้กับคอลัมน์ใดคอลัมน์หนึ่ง ฐานข้อมูลจะสร้าง “โครงสร้างข้อมูลพิเศษ” (มักจะเป็นรูปแบบ B-Tree) เพื่อเก็บตัวชี้เป้า (Pointer) ว่าข้อมูลแต่ละบรรทัดถูกเก็บไว้ที่ตำแหน่งไหนในฮาร์ดดิสก์ ทำให้ไม่ต้องไปสแกนหาข้อมูลใหม่ทั้งหมดทุกครั้ง
เบื้องหลังความเร็ว: เกิดอะไรขึ้นเมื่อระบบมี Index?
สมมติว่าเรามีตารางเก็บข้อมูลนักเรียน 50,000 คน และเราต้องการเขียนคำสั่ง SQL เพื่อค้นหานักเรียนที่รหัสประจำตัว “69001” (SELECT * FROM students WHERE student_id = '69001')
- ถ้าไม่ทำ Index (Full Table Scan): ระบบฐานข้อมูลจะก้มหน้าก้มตาอ่านข้อมูลตั้งแต่นักเรียนคนที่ 1, 2, 3… ไปเรื่อยๆ จนกว่าจะครบ 50,000 คน เพื่อให้แน่ใจว่าไม่มีรหัส 69001 หลุดรอดไป ซึ่งทำให้เซิร์ฟเวอร์ทำงานหนักและใช้เวลานาน
- ถ้าทำ Index ที่คอลัมน์ student_id (Index Seek): ระบบจะวิ่งไปดูที่ “สารบัญ” ของ student_id ซึ่งถูกจัดเรียงไว้อย่างเป็นระเบียบแล้ว และกระโดดข้ามไปหยิบข้อมูลของนักเรียนรหัส 69001 ออกมาได้ภายในเสี้ยววินาที
ทำไมถึงไม่ทำ Index ให้กับทุกคอลัมน์ไปเลยล่ะ?
หลายคนอาจจะคิดว่า ถ้า Index มันดีขนาดนี้ ก็ตั้งค่าให้ทุกคอลัมน์ในตารางเป็น Index ไปเลยสิ! แต่นั่นคือหลุมพรางของการออกแบบฐานข้อมูลค่ะ เพราะ Index มี ข้อแลกเปลี่ยน (Trade-offs) เสมอ:
- ทำให้การเพิ่ม/แก้ไข/ลบ (Create, Update, Delete) ช้าลง: ทุกครั้งที่เรามีการ INSERT ข้อมูลใหม่ หรือ UPDATE ข้อมูลเดิม ระบบไม่ได้แค่นำข้อมูลไปใส่ในตารางหลักเท่านั้น แต่ต้องวิ่งไปจัดเรียงและอัปเดต “หน้าสารบัญ (Index)” ให้เป็นปัจจุบันด้วย ยิ่งมี Index เยอะ การเขียนข้อมูลก็จะยิ่งช้าลง
- กินพื้นที่จัดเก็บ (Storage): ไฟล์ Index ต้องการพื้นที่ในฮาร์ดดิสก์เพื่อจัดเก็บตัวเอง ยิ่งตารางใหญ่และมี Index หลายตัว ขนาดของฐานข้อมูลก็จะยิ่งบวมขึ้น
คอลัมน์แบบไหนที่ “ควร” และ “ไม่ควร” ทำ Index?
✅ ควรทำ Index:
- คอลัมน์ที่ถูกใช้ในเงื่อนไข
WHEREบ่อยๆ (เช่น รหัสนักเรียน, อีเมลผู้ใช้งาน, สถานะคำร้อง) - คอลัมน์ที่ใช้ในการเชื่อมตาราง
JOIN(Foreign Keys) - คอลัมน์ที่ถูกนำมาใช้จัดเรียงข้อมูล
ORDER BYบ่อยๆ (เช่น วันที่บันทึกข้อมูล)
❌ ไม่ควรทำ Index:
- ตารางที่มีขนาดเล็กมากๆ (สแกนทั้งตารางเร็วกว่ามานั่งเปิดสารบัญ)
- คอลัมน์ที่มีข้อมูลซ้ำกันเยอะมาก (Low Cardinality) เช่น คอลัมน์ “เพศ” ที่มีแค่ ชาย กับ หญิง การทำ Index จะไม่ได้ช่วยให้หาข้อมูลเร็วขึ้นเท่าไหร่
- คอลัมน์ที่เก็บข้อความยาวๆ (TEXT) เพราะจะกินพื้นที่มหาศาล
การออกแบบฐานข้อมูลที่ดีจึงไม่ใช่แค่การเขียนโค้ดให้ดึงข้อมูลออกมาได้ แต่คือการบาลานซ์ระหว่าง “ความเร็วในการอ่าน (Read)” และ “ความเร็วในการเขียน (Write)” การเลือกทำ Index เฉพาะคอลัมน์ที่เป็นหัวใจสำคัญในการค้นหา จะช่วยให้ Web Application ของเราทำงานได้อย่างมีประสิทธิภาพ รองรับข้อมูลที่เติบโตขึ้นในอนาคตได้โดยที่ระบบยังคงตอบสนองได้อย่างรวดเร็วค่ะ

